converter-hub
Converte planilha, imagem e outros arquivos direto no navegador.
- TypeScript
- SQLite (WebAssembly)
- Vitest
tl;dr#
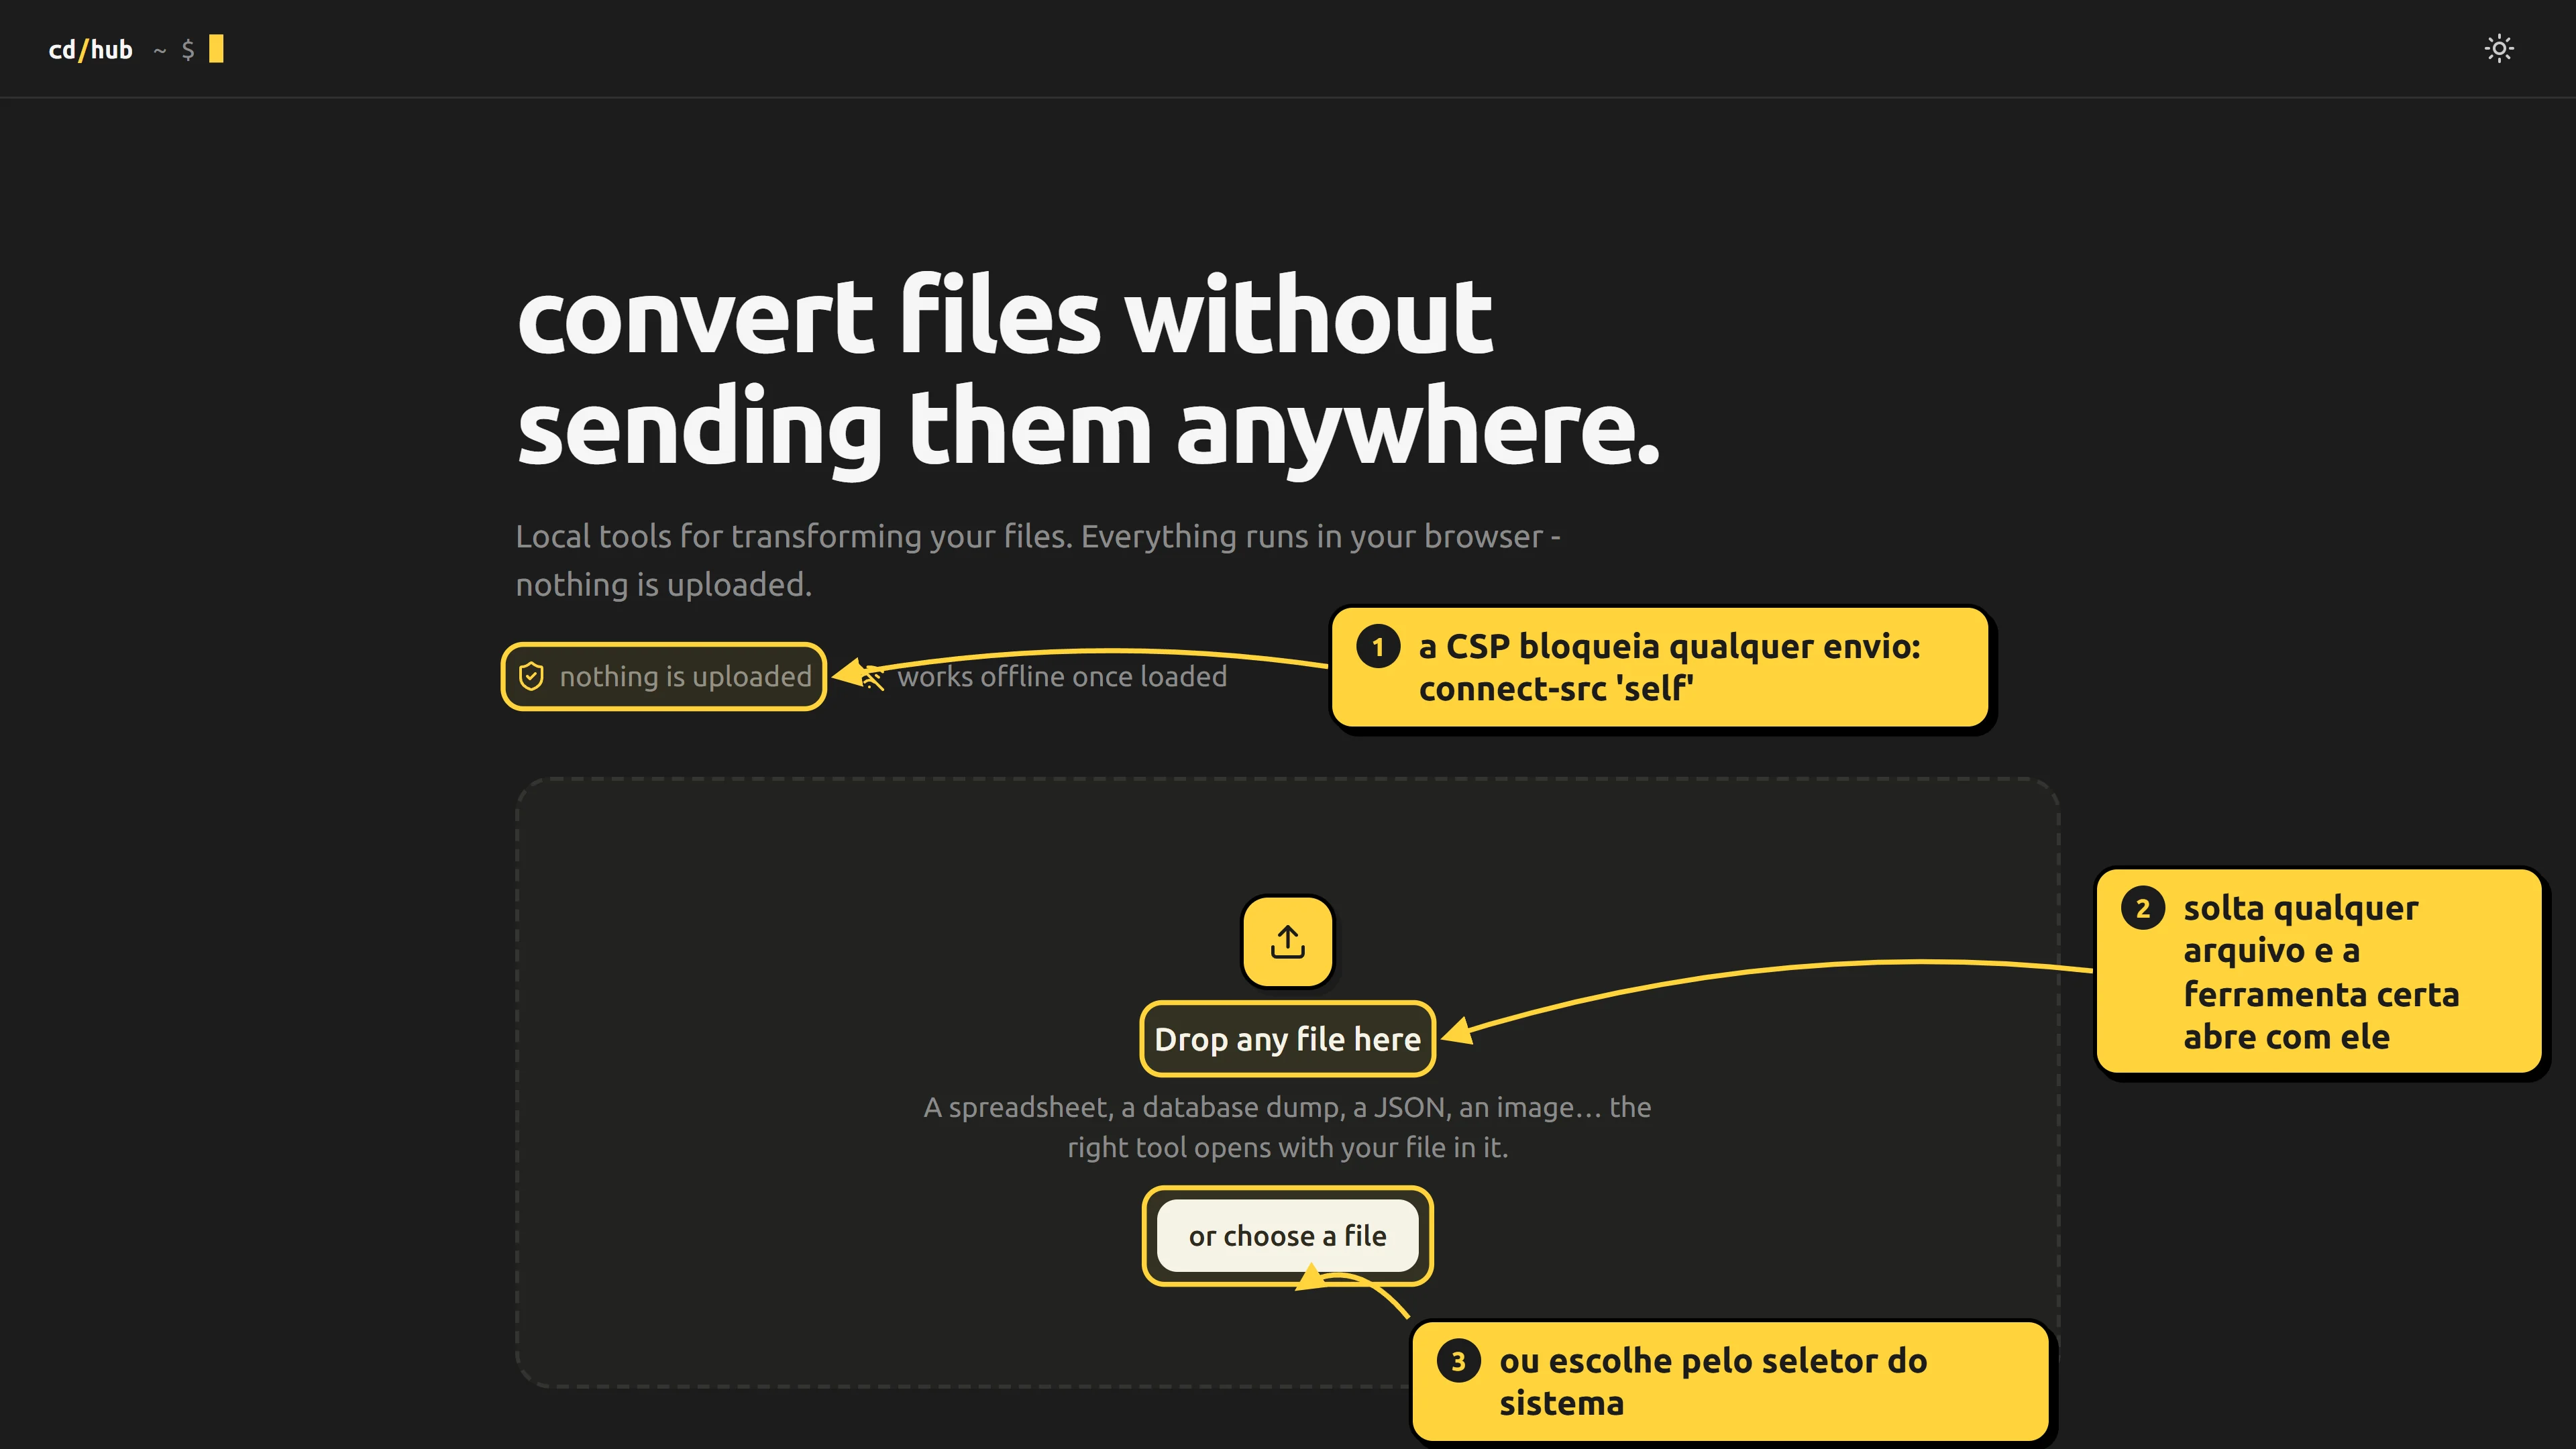
O converter-hub junta ferramentas pra converter planilha, banco, dado, texto e imagem direto no navegador. Seu arquivo não vai pra servidor nenhum: uma política de segurança do próprio app bloqueia qualquer tentativa de mandar ele pra fora da aba.
o problema#
converter um arquivo geralmente é subir ele num site qualquer. se o arquivo é uma planilha de clientes ou um dump de banco, aí complica: o dado vai pra um servidor que você nem conhece.
o que eu queria:
- converter sem upload e sem servidor pra manter;
- aceitar formato chato de verdade (dump de 24 motores de SQL, banco SQLite com WAL, arquivo do Firebird, backup do SQL Server);
- dar erro claro quando o arquivo não encaixa, em vez de entregar um resultado torto.
a ideia#
o navegador lê o arquivo, converte e devolve o resultado. três regras seguram o projeto:
- nada sai do computador. o arquivo é lido com
file.text()oufile.arrayBuffer(), e nenhuma requisição é feita pra processar dado. - nada do arquivo é executado. um dump de SQL é lido como texto e nunca roda. um banco SQLite abre só pra leitura.
- o que não encaixa é recusado, não adivinhado. arquivo grande demais, formato desconhecido ou JSON aninhado que não vira tabela: o app fala o motivo.
como fica#
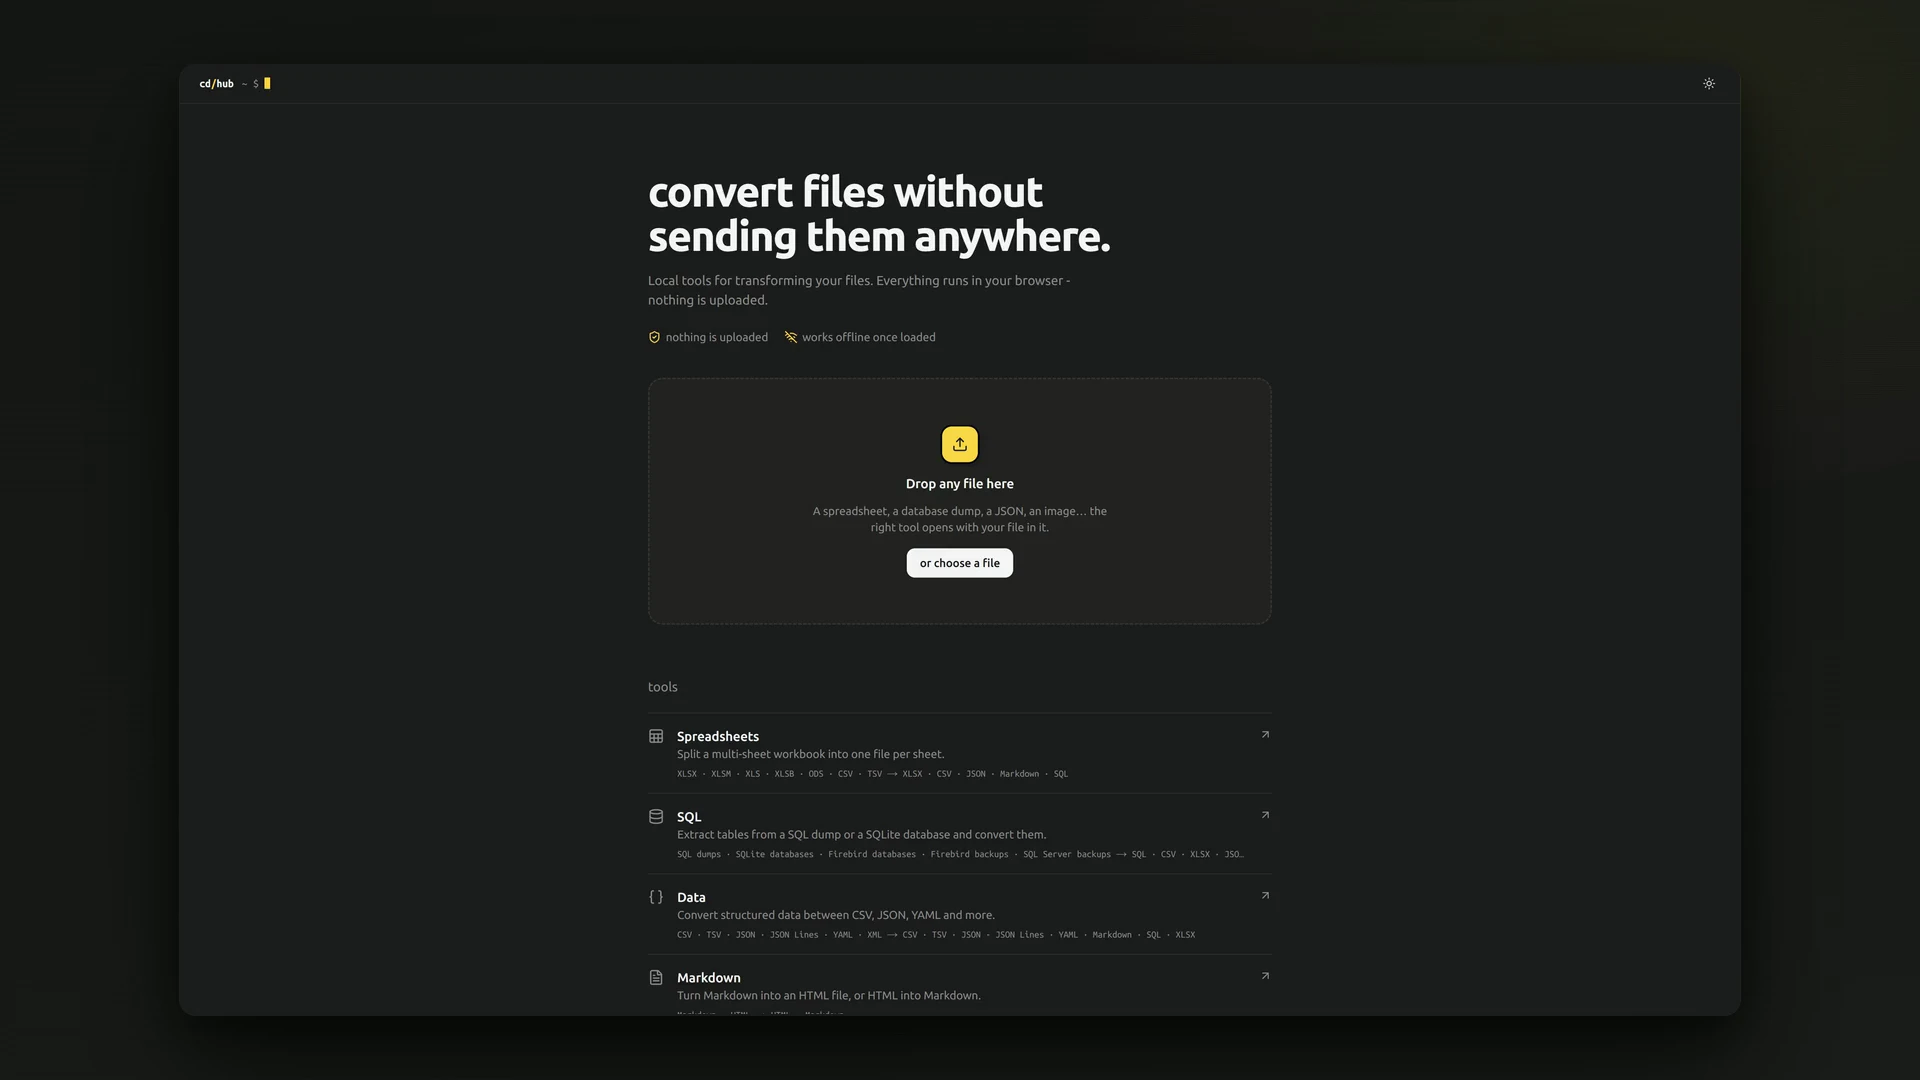
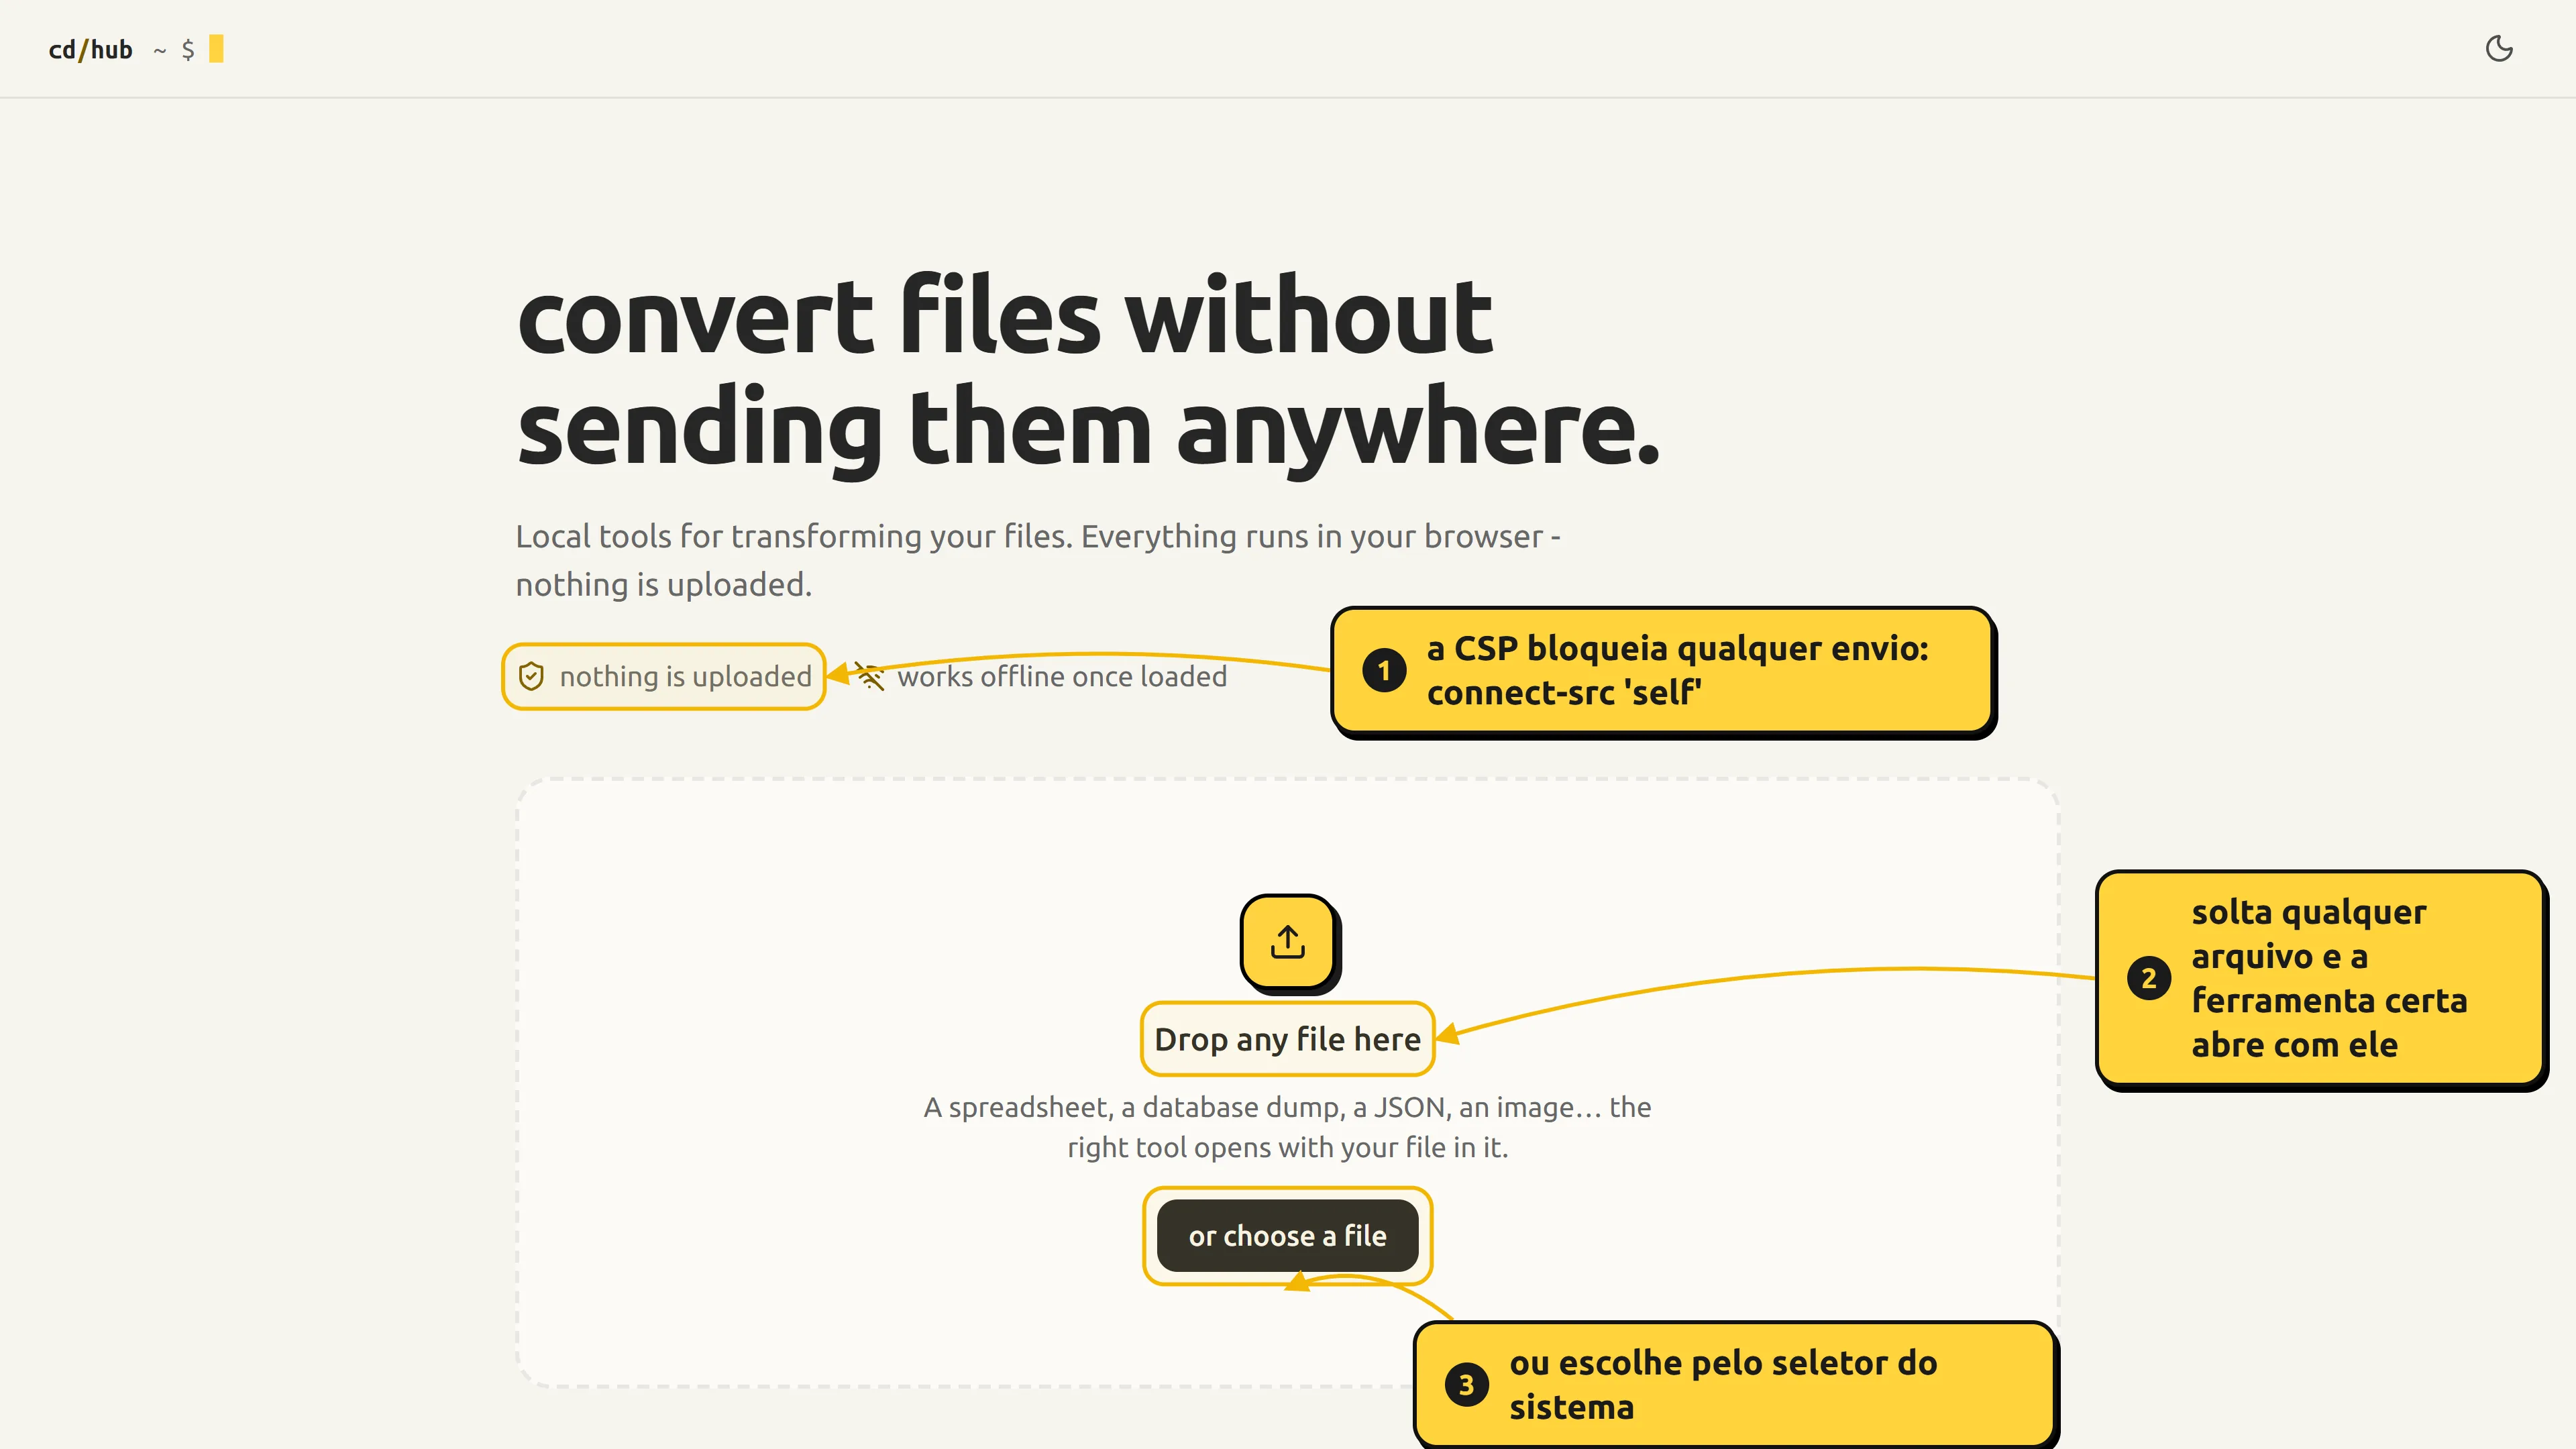
a home é um catálogo de ferramentas. dá pra soltar um arquivo direto na home também: o hub escolhe a ferramenta pela extensão, guarda o arquivo na memória e já te leva pra ela.
são seis ferramentas, cada uma com a sua rota:
| ferramenta | rota | lê | escreve |
|---|---|---|---|
| planilhas | /spreadsheet | XLSX, XLSM, XLS, XLSB, ODS, CSV, TSV | XLSX, CSV, JSON, Markdown, SQL |
| SQL | /sql | dumps de 24 motores, banco SQLite (com WAL), arquivos do Firebird 2.x a 5 e backups gbak, backups do SQL Server | SQL, CSV, XLSX, JSON, JSON Lines, Markdown |
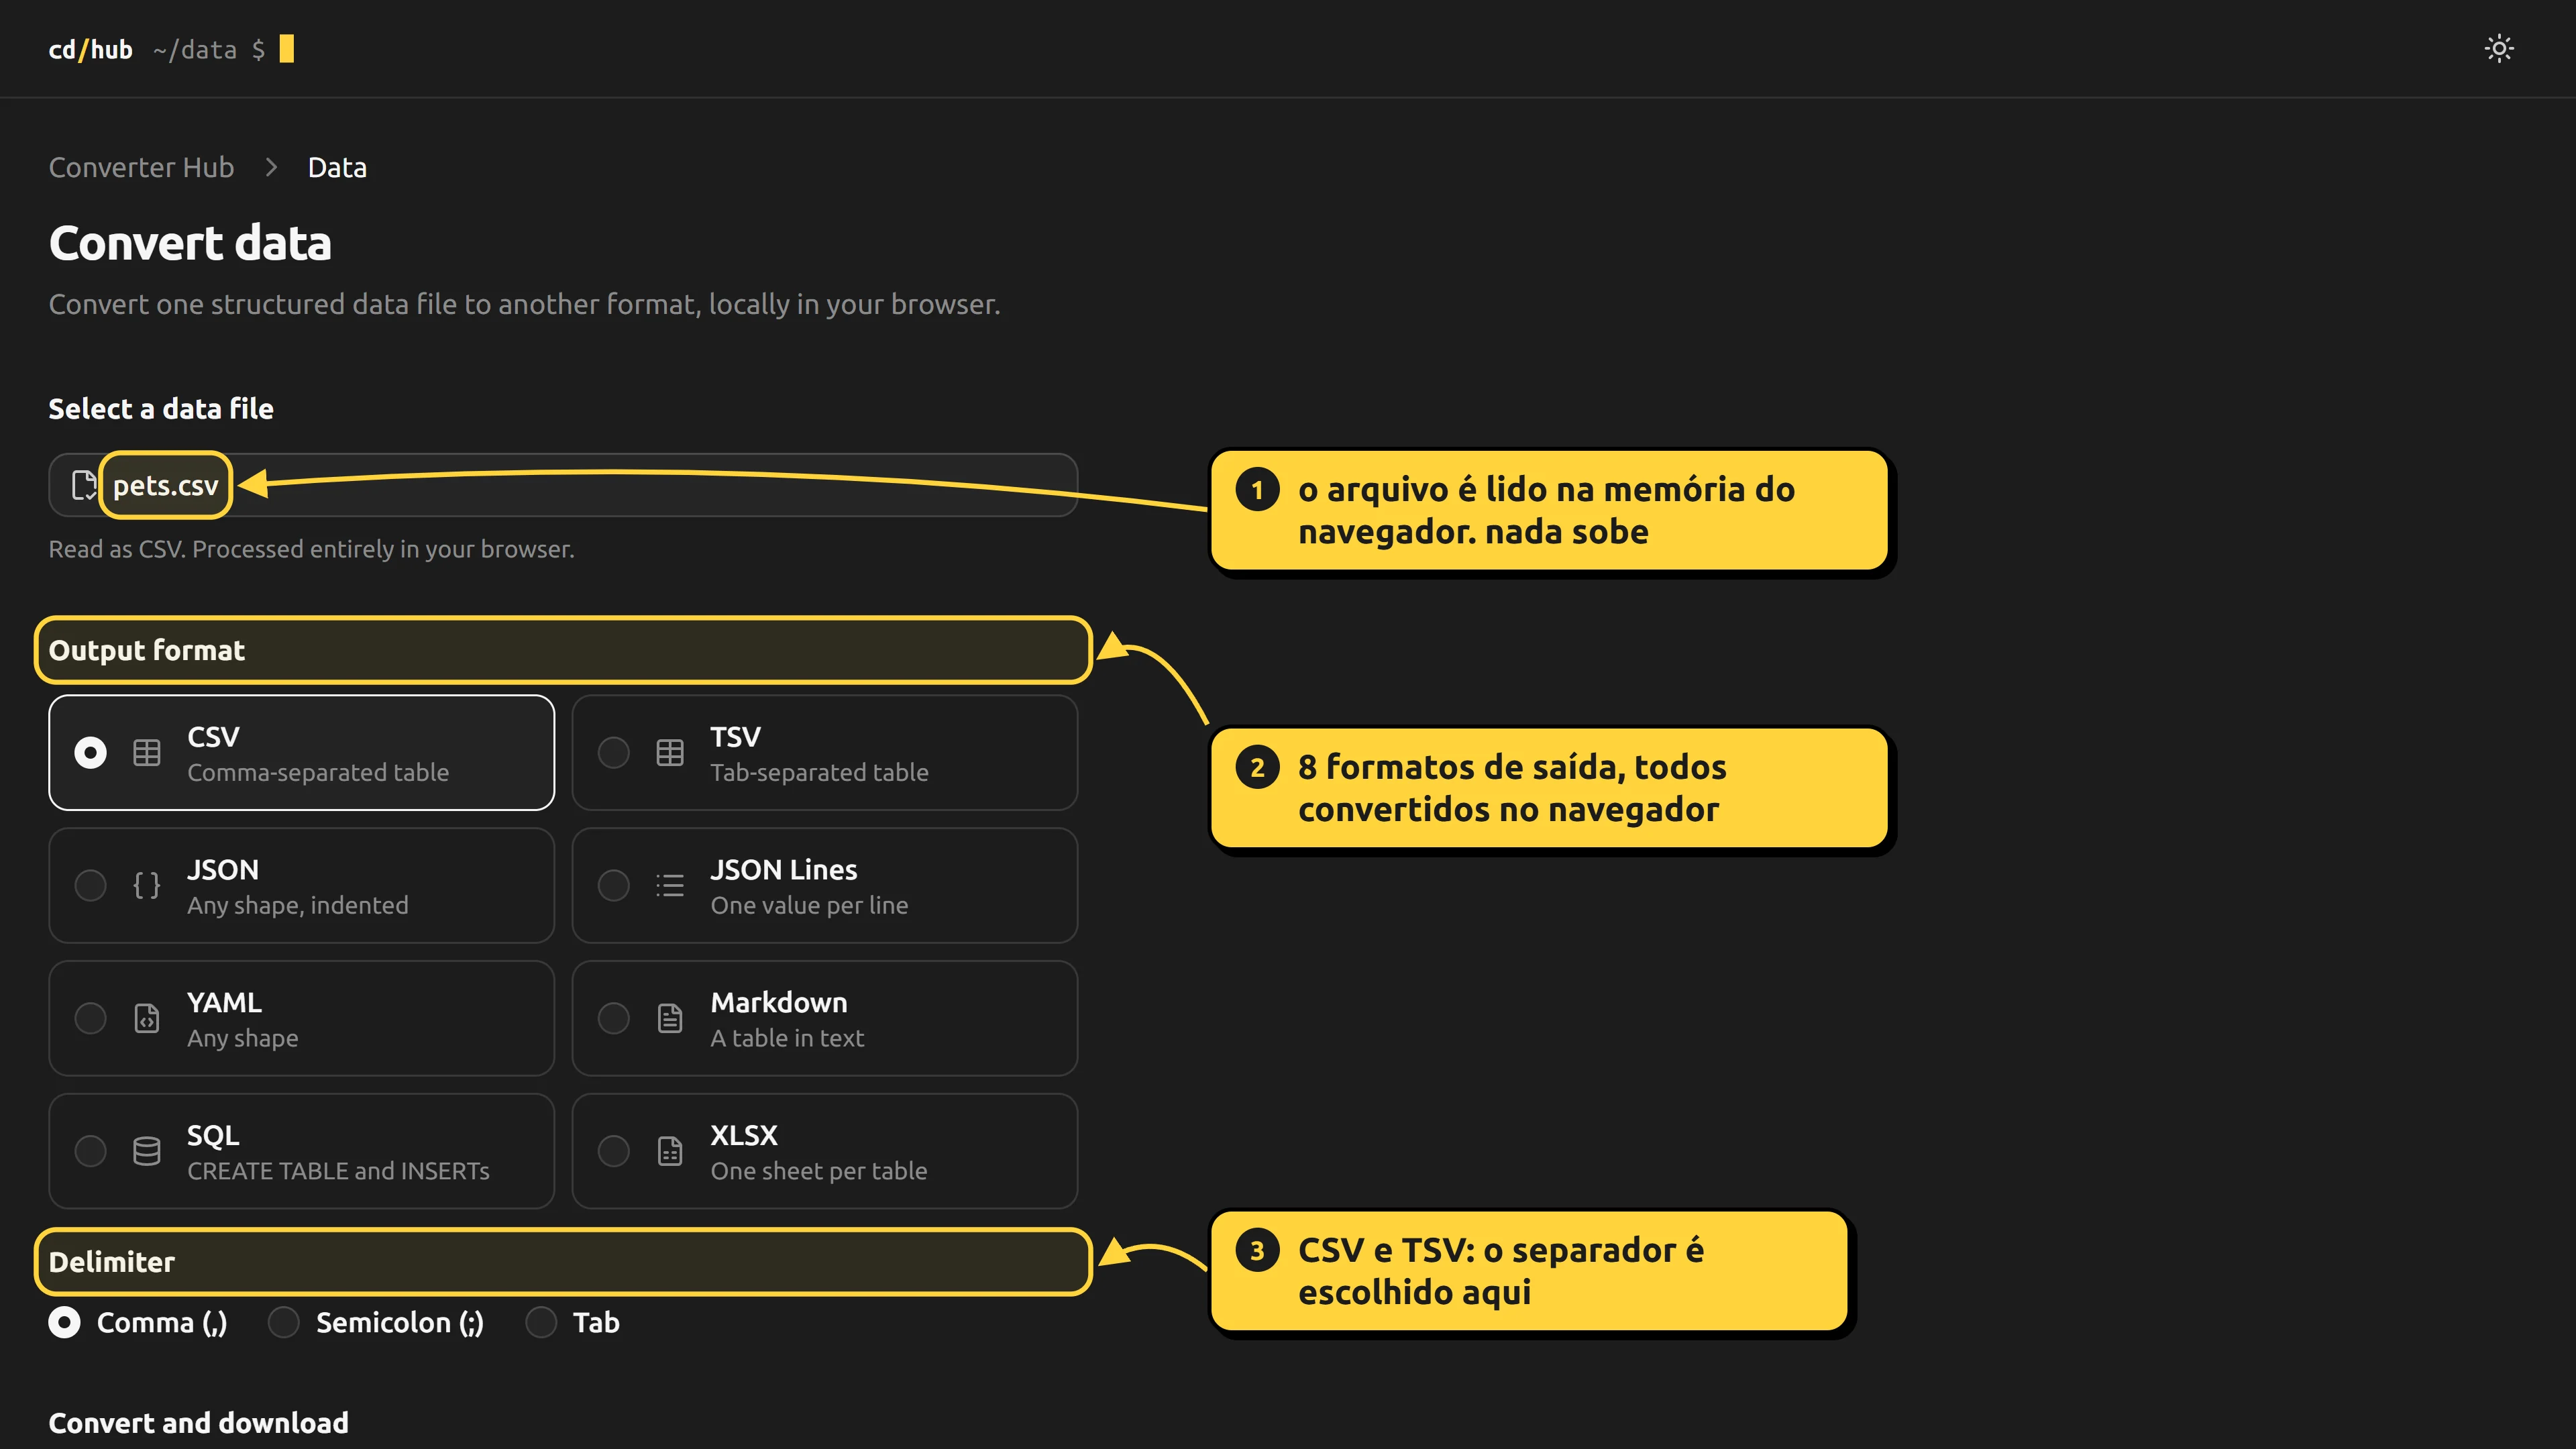
| dados | /data | CSV, TSV, JSON, JSON Lines, YAML, XML | CSV, TSV, JSON, JSON Lines, YAML, Markdown, SQL, XLSX |
| markdown | /markdown | Markdown, HTML | HTML, Markdown |
| JSON pra TypeScript | /json-to-typescript | JSON | TypeScript |
| imagens | /image | SVG, PNG, JPEG, WebP, AVIF | PNG, JPEG, WebP |
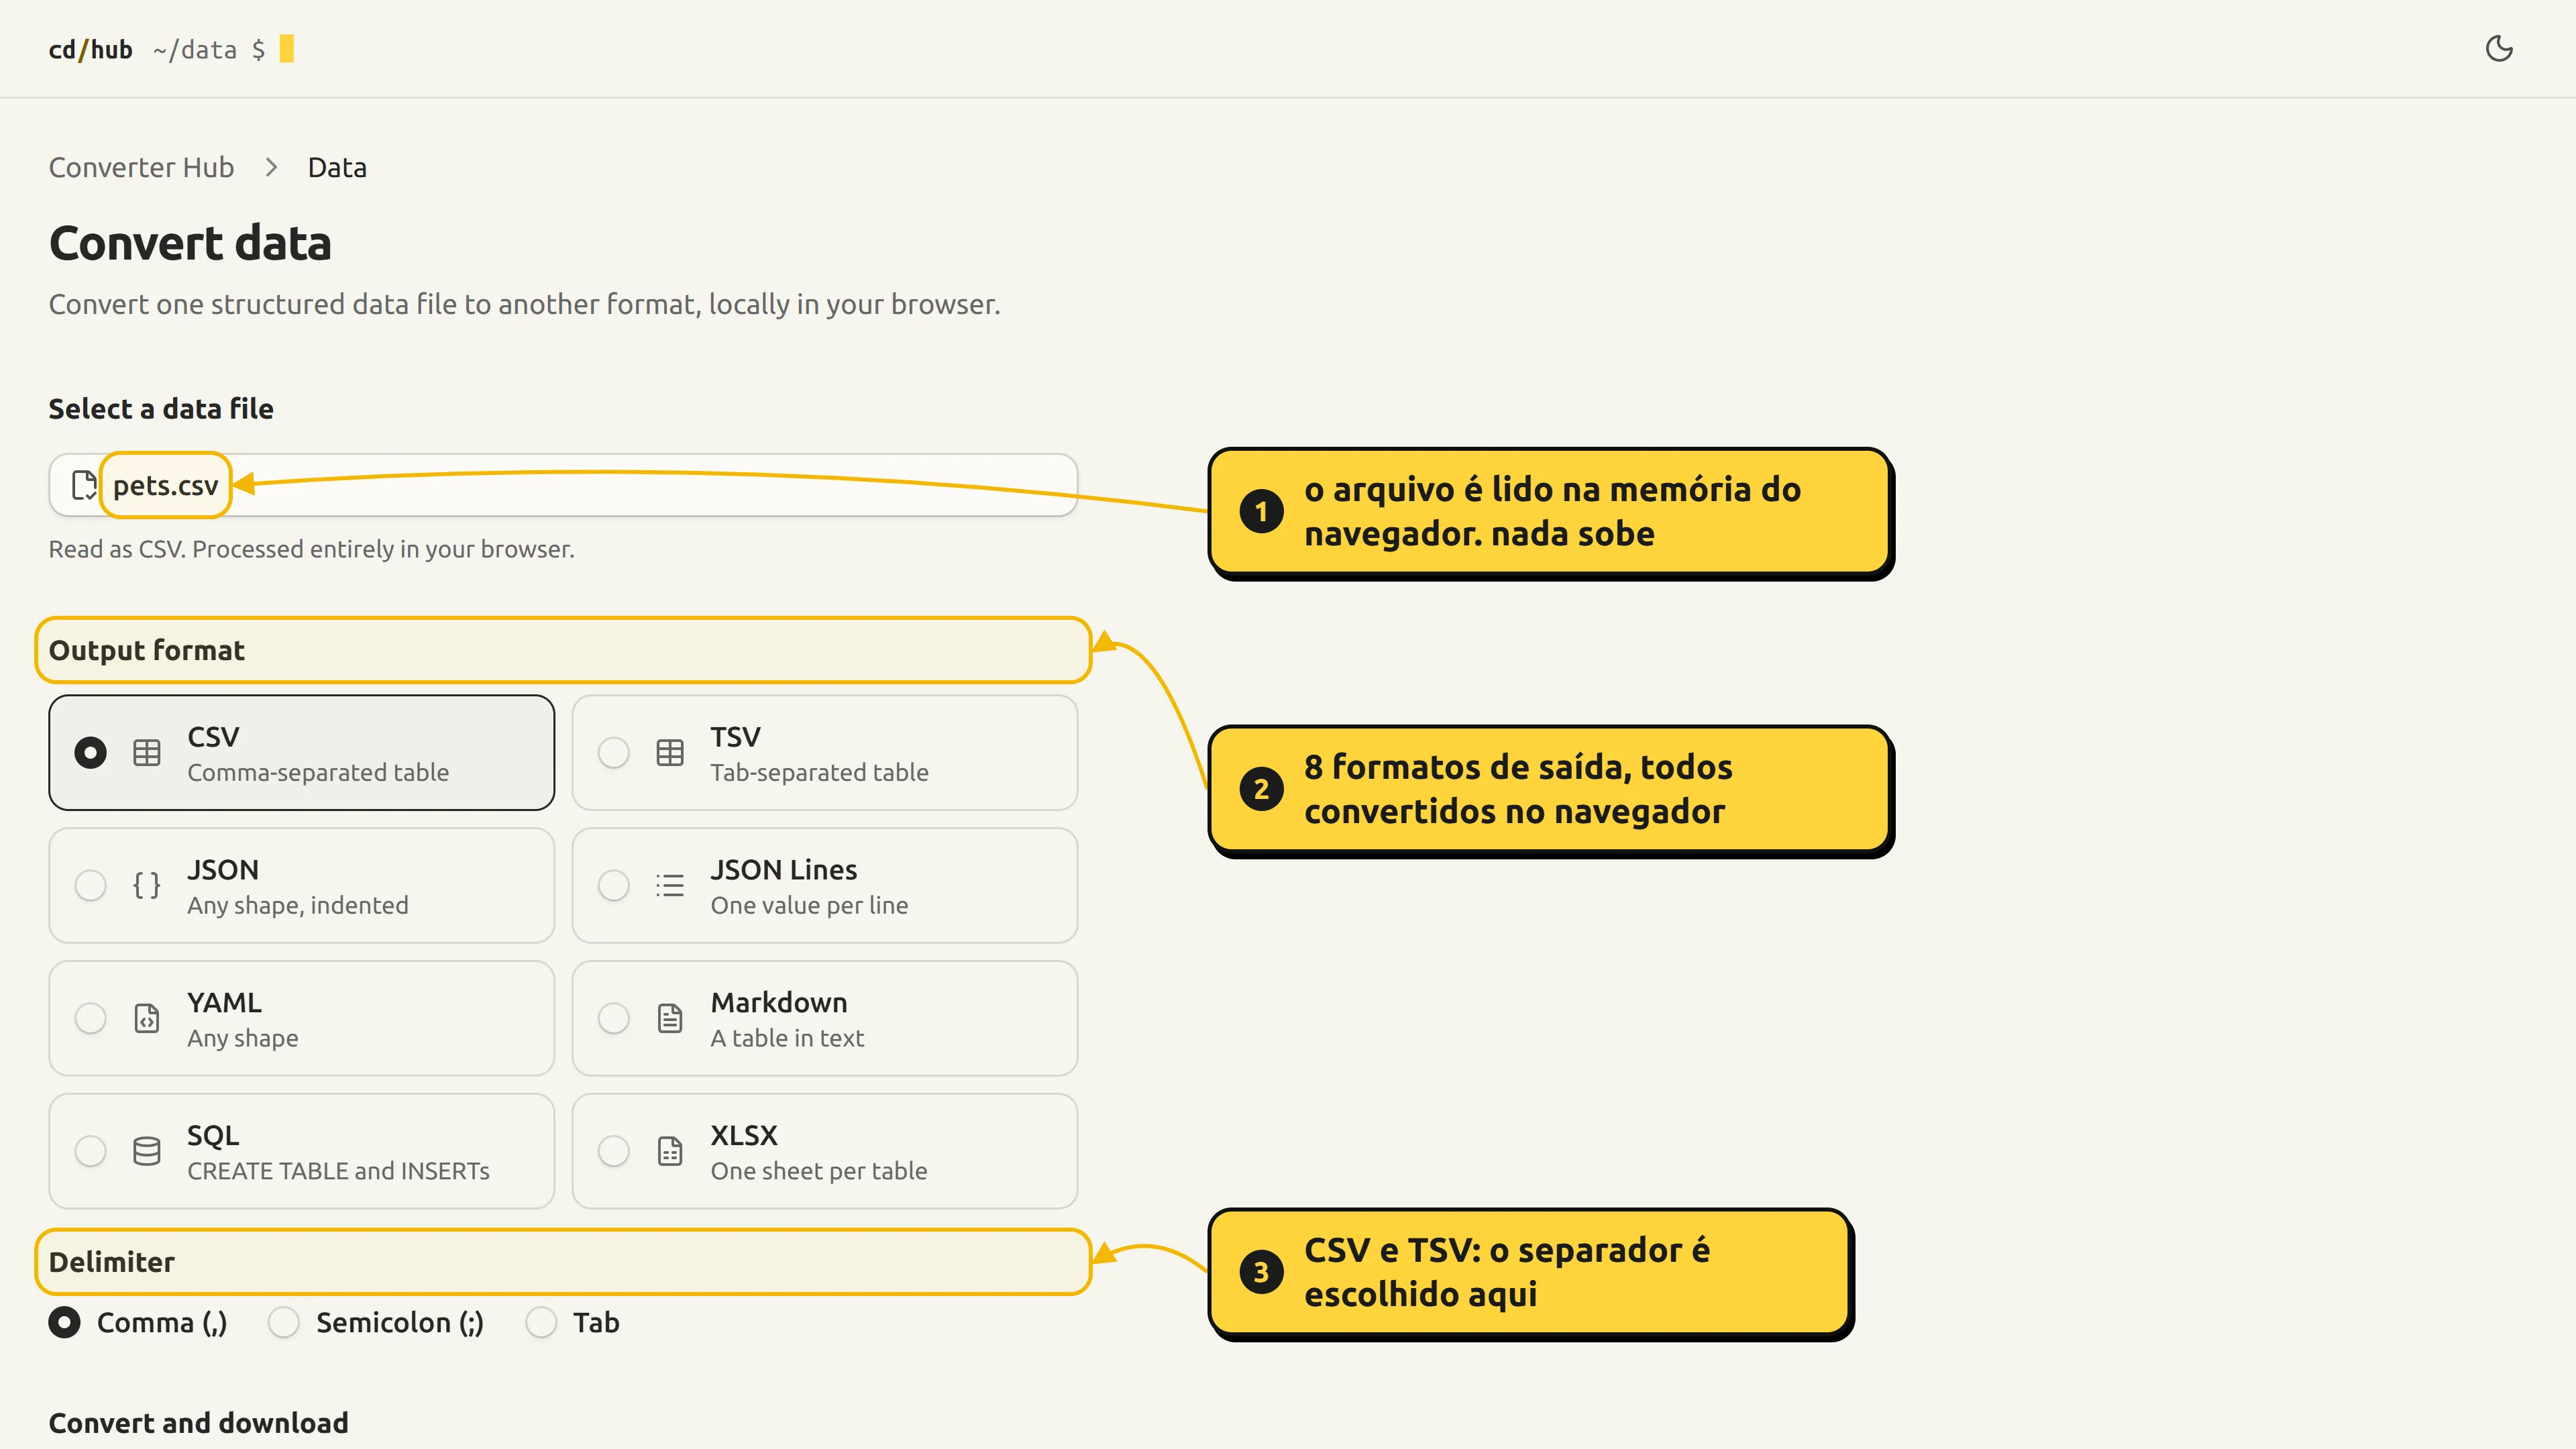
na ferramenta de dados, depois de carregar um CSV, o resultado já aparece pronto pra você escolher o formato e baixar:
como funciona por trás#
o repositório é um monorepo com duas partes que não se misturam: packages/core (leitura e escrita, sem I/O e sem UI) e apps/web (a interface em Next.js). tem também uma CLI, só pra ferramenta de SQL.
arquivo no disco
   │  file.text() / file.arrayBuffer()        (na aba, sem rede)
   ▼
detecta pelo conteúdo ─► parser ─► modelo normalizado ─► escritor ─► Blob ─► download
                         └──────── packages/core: sem I/O, sem UI ────────┘
o app web só liga as pontas: pega o File, chama o core e entrega o resultado como download (um Blob com URL.createObjectURL).
o catálogo fica num lugar só#
o apps/web/lib/tools.ts descreve cada ferramenta uma vez:
{
  id: 'spreadsheet',
  name: 'Spreadsheets',
  tagline: 'Split a multi-sheet workbook into one file per sheet.',
  href: '/spreadsheet',
  source: ['XLSX', 'XLSM', 'XLS', 'XLSB', 'ODS', 'CSV', 'TSV'],
  output: ['XLSX', 'CSV', 'JSON', 'Markdown', 'SQL'],
  // …
}
dessa lista saem os cards da home, os títulos, o breadcrumb e a metadata das rotas. só entra ali ferramenta que já tem rota: o hub nunca mostra o que ainda não existe. pra acrescentar uma ferramenta é uma entrada no catálogo e uma rota.
a ferramenta de dados: lê pra um valor, escreve a partir dele#
o jeito mais simples de converter qualquer formato em qualquer outro é passar por um meio-termo. no apps/web/lib/data-convert.ts, tudo vira um valor JavaScript simples e depois é escrito no formato de saída:
const content = await writeData(
  await readData(text, input),
  output,
  name,
  options,
)
o readData tem um case pra cada formato de entrada (csv, tsv, json, jsonl, xml, yaml), e o writeData um pra cada formato de saída. alguns detalhes que fazem diferença:
- JSON, JSON Lines e YAML aceitam qualquer formato de dado. CSV, TSV, Markdown, SQL e XLSX precisam de uma lista de registros planos. documento aninhado é recusado, porque achatar ia ser escolher uma forma por você.
- o delimitador do CSV é detectado pelo cabeçalho, e os valores continuam texto (
007continua007). - o YAML é lido com a biblioteca
yaml, que por padrão limita os aliases e recusa um documento que explode num grafo gigante a partir de poucos bytes. - o XML é lido pelo
DOMParserdo navegador, que não executa nada nem busca entidade externa, e vira uma forma fixa (@atributo,#text, lista pra elemento repetido).
a ferramenta de SQL: um parser por dialeto#
um dump de SQL é lido como texto. cada motor de banco é um parser atrás de uma interface pequena no packages/core/src/parser/shared/format-parser.ts:
export interface FormatParser {
  format: DatabaseFormat
  parse(sql: string): SqlDump
  readColumns(createStatement: string): string[]
  readDataBlock(statement: string): DataBlock
  countDataRows(statement: string): number
}
o SQL específico de cada dialeto fica só em parser/<formato>/. todo o resto (o extrator, os geradores e a UI) trabalha em cima do modelo normalizado. então pra suportar mais um motor é escrever um parser e registrar, sem mexer em mais nada.
a detecção é bem cautelosa. primeiro ela acha a família por marcadores que o grupo todo tem, depois o membro por marcadores que só aquele produto escreve. se aparecem marcadores de duas famílias e não dá pra separar direito, ela não responde, em vez de chutar. e um formato só aparece como suportado depois de ter parser, fixture sintética e teste: um teste de matriz passa todos eles por detecção, parsing e as três exportações.
banco SQLite sem executar nada do arquivo#
banco SQLite é binário, então ele é aberto por um motor SQLite (wa-sqlite, em WebAssembly) rodando na aba. o arquivo vai pra um sistema de arquivos na memória e abre só pra leitura:
const db = await sqlite3.open_v2('db', SQLite.SQLITE_OPEN_READONLY, 'memory')
// impede que views e triggers do próprio arquivo chamem funções com efeito colateral
await sqlite3.exec(db, 'PRAGMA trusted_schema=OFF')
a ferramenta diferencia dump de banco pelo conteúdo, não pelo nome: arquivo que começa com o cabeçalho do SQLite (ou que vem com um -wal) é banco, e qualquer outro é lido como dump. um texto renomeado pra .db continua sendo texto.
se você seleciona o -wal junto, as linhas mais recentes entram, e a ferramenta avisa. não tem parser de WAL feito na mão: quem aplica o log é um SQLite de verdade. um -wal com checksum inválido é recusado, porque o SQLite sozinho ia tratar ele como vazio e exportar o banco sem as linhas novas, sem avisar ninguém.
formato binário sem o motor original#
arquivo .fdb do Firebird e backup .fbk do gbak são lidos direto da estrutura em disco, seguindo o código-fonte do próprio Firebird, sem precisar de Firebird nenhum. o backup do SQL Server é um container Microsoft Tape Format em volta das páginas de 8 KB do banco: o core acha a primeira página, varre o arquivo atrás das páginas de dados e lê o catálogo a partir delas, sem restaurar nada. o que o core não sabe ler (tabela com ARRAY no Firebird, backup criptografado) aparece como ilegível ou é recusado com o motivo, nunca adivinhado.
quem garante a privacidade é o navegador#
o app manda uma Content Security Policy no apps/web/next.config.ts:
"default-src 'self'",
`script-src 'self' 'unsafe-inline' 'wasm-unsafe-eval'`,
"connect-src 'self'",
"object-src 'none'",
"base-uri 'self'",
"form-action 'self'",
"frame-ancestors 'none'",
o connect-src 'self' e o form-action 'self' não deixam nenhuma dependência mandar o arquivo pra fora, e o wasm-unsafe-eval tá ali por causa do motor SQLite. o 'unsafe-inline' no script é uma troca que eu assumi: sem ele só dá com nonce, que obriga toda página a renderizar dinâmica e perde o prerender estático. como não tem HTML do usuário sendo renderizado, nada lido da URL e nenhum servidor, o ataque que isso evitaria não tem por onde entrar.
decisões#
core sem I/O e sem UI. a leitura e a escrita são código puro, dá pra testar sem navegador. a CLI e a web usam o mesmo core.
recusar em vez de adivinhar. o limite é checado pelo tamanho, antes de ler um byte: dump acima de 250 MB e planilha acima de 100 MB são barrados com uma mensagem, em vez de estourar a memória no meio. formato que perde informação avisa o que vai se perder antes de exportar. e formato com ressalva mas sem perda não avisa, pra ninguém se acostumar a ignorar o aviso que importa.
nada de adivinhar tipo. o SQLite não tem tipo de data, então um inteiro que parece timestamp continua inteiro. o CSV sai do mesmo escritor das outras ferramentas, que neutraliza =, +, - e @ no começo da célula.
sem biblioteca onde o navegador já resolve. a ferramenta de imagem não usa nenhuma: o navegador decodifica pela Image, desenha num canvas e codifica com canvas.toBlob. um SVG é carregado por <img> a partir de uma URL de Blob, onde o navegador não roda script nem busca recurso de fora. o JPEG é pintado em cima de branco, porque não tem transparência, e o AVIF só é lido, não aparece como saída.
nome de arquivo é entrada que não dá pra confiar. o nome de uma aba da planilha vira nome de arquivo dentro de um ZIP, então separador de caminho, ponto no começo e caractere de controle são tratados.
status e próximos passos#
as seis ferramentas da home funcionam e têm teste (Vitest). o fluxo de qualidade do repositório exige tipos, lint, formatação, testes e build passando. outras quatro ferramentas de texto (Base64/hex/URL, estilos de identificador, timestamps e cores) tão prontas e testadas no core, mas ficam fora da home, em apps/web/app/_parked, até ganharem lugar.
limites que eu assumo:
- a leitura não é streaming: um dump vira uma string só, então o pico de memória é um múltiplo do arquivo (por isso o teto de 250 MB);
- cada parser entende o que a ferramenta de dump do motor escreve, não é um parser de SQL universal;
- a ferramenta de planilhas divide por aba: valor e fórmula sobrevivem no XLSX, mas cor, borda e largura de coluna não. ela não é um editor de planilha;
- markdown qualquer em HTML não converte perfeito.